스노우플레이크, ‘자율형 데이터 엔지니어링’으로 실시간 데이터 기반의 에이전틱 엔터프라이즈 구현
코코 클라우드 에이전트·코코 오토메이션으로 반복적인 파이프라인 관리 자동화, 엔지니어는 가이드라인만 제시
대시보드·앱·AI 에이전트 구동하는 엔드투엔드 실시간 분석 기능… 선제적 대응으로 전환 지원
코드 변경 최소화로 쉬워진 아파치 스파크 워크로드 이전… 더 많은 데이터에 거버넌스 적용 및 AI 활용 지원
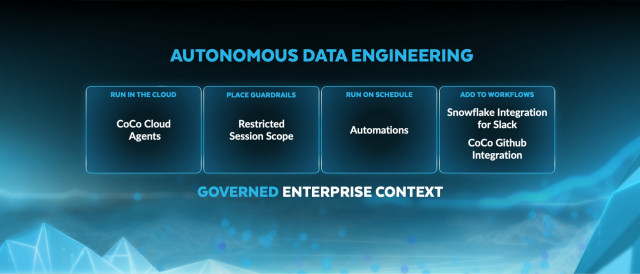
AI 에이전트를 통해 데이터 파이프라인을 안정적으로 유지하고, 기업이 즉시 활용 가능한 실시간 데이터를 확보하도록 지원하는 스노우플레이크 신규 혁신 기술
서울--(뉴스와이어)--글로벌 AI 데이터 클라우드 기업 스노우플레이크(Snowflake)가 ‘스노우플레이크 엑스페디션 2026(Snowflake Expedition 2026)’에서 기업이 AI 에이전트에 필요한 신뢰할 수 있는 데이터 기반을 구축하고 운영할 수 있도록 하는 ‘자율형 데이터 엔지니어링(Autonomous Data Engineering)’과 실시간 분석의 새로운 기능을 발표했다.
자율형 데이터 엔지니어링은 AI 에이전트가 데이터 파이프라인 구축·운영·수정 등 반복적인 작업을 수행하는 것으로 엔지니어는 프로덕션 환경에 반영할 내용만 결정하면 된다. 데이터 팀은 더 빠른 개발을 지원하는 코딩 에이전트 ‘스노우플레이크 코코(Snowflake CoCo, 이하 ‘코코’)’의 신규 기능으로 파이프라인 복구 같은 반복 작업을 자동으로 처리하는 워크플로우를 만들 수 있다. 엔드투엔드(end-to-end) 실시간 분석 기능은 비즈니스 전반에서 발생하는 데이터를 파이프라인에 실시간으로 공급하고, 데이터가 유입되는 순간부터 모든 활용 단계에 동일한 거버넌스를 적용한다.
기업들이 AI 에이전트에 더 많은 의사결정을 맡기면서 데이터의 신뢰성은 그 어느 때보다 중요해졌다. 에이전트가 이미 지난 수치나 오류가 발생한 파이프라인을 이용하면 잘못된 정보를 기반으로 실행은 계속된다. 에이전트의 작동과 비즈니스 속도를 모두 고려하면 오류는 빠르게 누적될 수밖에 없다. 하지만 많은 기업의 데이터는 여전히 수작업으로 작성한 파이프라인과 여러 툴을 조합한 스트리밍 시스템에 의존하고 있으며 데이터 팀은 아직도 시간 소요가 크다.
스노우플레이크의 최신 기능은 기업이 자신 있게 AI를 확장하도록 돕는다. 에이전트는 거버넌스가 적용된 실시간 데이터를 기반으로 실행해 의사결정의 속도를 높이고, 데이터 팀은 핵심 업무를 더 많이 수행할 수 있게 된다.
크리스티안 클레이너만(Christian Kleinerman) 스노우플레이크 제품 담당 수석부사장은 “AI 성과를 이끄는 데이터 팀이 아직도 상당 부분 수작업으로 데이터 정확성을 확인하고 있다. 하지만 데이터 규모가 폭발적으로 증가하고 에이전트가 맡는 업무가 늘어나는 상황에서 이런 방식은 한계가 있다”며 “스노우플레이크는 데이터 엔지니어링에 자율형 에이전트를 도입하고 실시간 데이터를 단일 거버넌스 플랫폼에 통합해 데이터 팀이 더 새로운 가치를 창출할 수 있는 일에 집중할 수 있도록 돕는다”고 말했다.
반복적인 데이터 작업은 에이전트에게… 조직은 비즈니스 성과에 집중
‘코코 클라우드 에이전트(CoCo Cloud Agents)’를 활용하면 조직은 엔지니어 개인의 노트북 대신 스노우플레이크가 관리하는 분리된 클라우드 환경에서 코코를 실행할 수 있다. 각 세션은 별도의 보안 컨테이너에서 실행되며, 공유되는 ‘스노우플레이크 워크스페이스(Snowflake Workspace)’의 파일을 기반으로 작업한다. 데이터 엔지니어는 ‘코코 제한 세션 범위(CoCo Restricted Session Scope)’를 통해 각 세션이 수행할 수 있는 작업을 추가로 제한할 수도 있다. 또한 모든 과정이 클라우드에서 이뤄지기 때문에 엔지니어가 로그오프해도 작업이 이어지며, 장시간의 작업과 팀 간 협업을 지원한다.
‘코코 오토메이션(CoCo Automations)’을 활용하면 데이터 팀은 에이전트를 예약 실행할 수 있다. 데이터 엔지니어는 파이프라인 상태 점검이나 실패한 작업 원인 분석처럼 반복적인 작업을 자연어로 설명하고, 실행 주기만 설정하면 된다. 팀은 직접 구축한 ‘코코 스킬스(CoCo Skills)’를 공유할 수 있어 엔지니어 한 명이 만든 워크플로우를 팀에서 재사용할 수 있다. 특히 스노우플레이크 내부에서 실행되기 때문에 조직의 리니지, 카탈로그, 거버넌스 정책과 연동되며 범용 코딩 어시스턴트에는 없는 맥락 정보를 확보할 수 있다.
예약된 실행 과정에서 파이프라인 문제가 발견되면 코코는 원인을 추적하고 수정안을 제안한다. 엔지니어는 이를 검토한 뒤 프로덕션에 반영할 변경 사항을 결정한다. 퍼블릭 프리뷰로 공개 예정인 ‘스노우플레이크 포 슬랙(Snowflake for Slack)’을 이용하면 팀이 사용 중인 업무 채널에서 코코를 바로 활용할 수 있어 스레드를 벗어나지 않고도 질문, 워크플로우 실행, 결과 검토를 할 수 있다. ‘코코 깃허브 통합(CoCo GitHub Integration, 퍼블릭 프리뷰)’을 통해 코코가 제안한 코드 변경 사항 역시 팀의 기존 검토 프로세스를 준수하며 처리된다.
이러한 혁신은 자율형 데이터 엔지니어링의 기반이 된다. 팀은 코코 기반 에이전트를 생성·배포·관리할 수 있다. 이 에이전트는 파이프라인 문제를 자동으로 감지해 복구하고, 수정안이 승인 가능한 상태가 되면 엔지니어에게 알린다.
기존 파이프라인을 운영하는 것만으로는 충분하지 않다. AI가 확장됨에 따라 조직은 새로운 파이프라인도 더 빠르게 구축해야 한다. ‘스노우플레이크 파이프라인 빌더(Snowflake Pipeline Builder, 퍼블릭 프리뷰)’를 통해 조직은 ‘스노우플레이크 워크스페이스(Snowflake Workspaces)’의 비주얼 에디터에서 각 단계를 연결해 파이프라인을 오케스트레이션하거나 구축 작업을 코코에 맡길 수도 있다. 옥스머니(auxmoney), 뉴 아메리칸 펀딩(New American Funding) 등의 기업은 이미 파이프라인 빌더를 활용해 오류를 줄이면서 파이프라인을 더 빠르게 운영 환경에 반영하고 있다.
마리우스 가르보프스키(Marius Garbowski) 옥스머니 데이터·애널리틱스 부사장은 “옥스머니는 유럽을 대표하는 소비자 신용 디지털 대출 플랫폼으로서 리스크 및 애널리틱스 팀이 스노우플레이크의 정확하고 거버넌스가 잘 갖춰진 데이터에 의존하고 있다”며 “파이프라인 빌더는 팀이 구축한 각 단계를 엔드투엔드 파이프라인으로 연결해 새로운 인사이트가 모델을 개선하고 비즈니스로 더 빨리 이어지도록 한다”고 말했다. 이어 “자체 툴을 조합하는 대신 스노우플레이크의 데이터 기반을 사용하게 되면서 해당 팀은 핵심 비즈니스를 위한 데이터 사이언스와 모델에 더욱 집중할 수 있게 됐다”고 덧붙였다.
디안 쉬(Dian Xu) 뉴 아메리칸 펀딩 엔지니어링 부사장은 “스노우플레이크 도입 이후 데이터 팀이 비즈니스에 제공할 수 있는 역할이 크게 달라졌다”며 “수백 개의 레거시 파이프라인과 리포트를 현대화하는 과정에서 스노우플레이크 코코가 까다로운 작업의 상당 부분을 맡아 왔다. 파이프라인 빌더는 이 작업 결과들을 믿고 매일 일관되게 활용할 수 있는 파이프라인으로 전환할 수 있게 했다. 이를 통해 엔지니어들은 대출자와 대출 담당자에게 시간을 더 쏟을 수 있었다”고 덧붙였다.
단일 거버넌스 플랫폼에서 엔드투엔드 실시간 분석 구현… 기업의 신속한 실행 지원
영업 대시보드를 하루 종일 최신 상태로 유지하거나 고객이 앱에서 정확한 계정 정보를 확인할 수 있도록 하는 등 실시간으로 일어나는 상황에 즉각 대응해야 하는 기업이 늘고 있다. 그러나 실시간 데이터를 확보하려면 일반적으로 각기 다른 비용 구조와 보안 규칙을 가진 여러 개의 별도 툴을 추가해야 했다. 이는 시간이 지나면서 비용 증가로 이어지고, 팀마다 서로 일치하지 않는 수치로 업무를 하게 만든다.
스노우플레이크의 실시간 분석 기능은 실시간 데이터의 수집부터 활용까지 전 과정을 단일 거버넌스 플랫폼에서 지원한다. 앱과 디바이스는 ‘스노우파이프 스트리밍(Snowpipe Streaming)’을 통해 데이터를 스노우플레이크로 직접 전송할 수 있으며, ‘엘라스틱 채널(Elastic Channels)’을 통해 데이터양이 증가하면 자동으로 확장된다. 오픈소스 분산 이벤트 스트리밍 플랫폼인 아파치 카프카(Apache Kafka®)를 사용 중인 기업은 퍼블릭 프리뷰 예정인 ‘스노우플레이크 데이터스트림(Snowflake Datastream)’을 활용해 앱을 스노우플레이크에 바로 연결할 수 있다. 브로커나 커넥터를 별도로 관리할 필요가 없다.
이를 통해 민티드(Minted), 넥슨(Nexon), 자이웨이브(Zywave)는 클러스터 인프라 유지보다 안전하고 거버넌스가 적용된 데이터 자산 구축에 집중하고 있다. 데이터가 유입되면 ‘스트리밍 트랜스포메이션(Streaming Transformations, 프라이빗 프리뷰)’을 통해 이동 중인 데이터를 표준 SQL로 변환할 수 있다. 다운스트림 데이터를 항상 최신 상태로 유지하고 수 초 내에 분석과 앱에 활용할 수 있게 한 것이다. 이에 데이터 엔지니어는 필요한 내용을 자연어로 설명하기만 하면 코코에서 모든 단계를 구축하고 실행할 수 있다.
강덕원 넥슨 AI 본부장은 “매일 수백만 명의 플레이어가 우리 게임과 상호작용하며, 그 행동 데이터는 게임 디자인부터 라이브 운영까지 모든 의사결정의 기반이 된다”며 “스노우플레이크는 흩어져 있는 데이터를 하나로 모으는 플랫폼으로, 스노우플레이크 기반의 AI 분석을 도입한 이후 의사결정 속도가 65% 빨라졌으며, 게임 운영 전반에 실질적인 변화를 가져오고 있다”고 말했다. 이어 “또한 게임 로그뿐 아니라 비정형 업무 데이터까지 스노우플레이크에 적재해 AI가 이를 컨텍스트로 활용할 수 있도록 하고 있으며, 이를 통해 팀들이 플레이어의 행동에 더 빠르게 대응하고, 경험을 지속적으로 개선하는 것이 훨씬 수월해졌다”고 덧붙였다.
‘인터랙티브 애널리틱스(Interactive Analytics)’는 이렇게 유입된 실시간 데이터를 실제 비즈니스에 활용하는 단계다. 많은 기업이 고객 대상 대시보드와 앱을 구동하기 위해 별도의 서빙 데이터베이스를 운영한다. 다수의 사용자와 에이전트가 동시에 쿼리하면 주력 분석 플랫폼의 속도가 저하되기 때문이다. 인터랙티브 애널리틱스는 수요가 집중되는 시점에도 스노우플레이크에서 앱과 AI 에이전트에 1초 미만의 빠른 실시간 응답을 직접 제공한다. 별도 시스템을 추가로 도입해 비용을 지불하거나 동기화를 관리할 필요도 없다. 데이터는 한 번만 저장되고 첫 이벤트부터 거버넌스가 적용되므로, 사용량이 늘어도 비용을 예측할 수 있고 모든 사용자와 에이전트가 신뢰할 수 있는 동일한 데이터를 기반으로 작업한다. 현재 기업은 스노우플레이크의 실시간 분석 기능을 통해 초당 최대 20GB의 데이터를 스노우플레이크로 스트리밍할 수 있으며, 데이터는 중앙값 기준 3초 이내에 활용 가능한 상태가 된다.
시카고 옵션 거래소(Cboe Global Markets) 등의 고객은 스노우플레이크의 실시간 분석 기능을 활용해 고비용의 독립형 시스템을 대체하고, 대규모 실시간 데이터를 기반으로 즉각 대응하고 있다.
케빈 냅(Kevin Knapp) 시카고 옵션 거래소 소프트웨어 엔지니어링 시니어 디렉터는 “시카고 옵션 거래소의 글로벌 거래 시장은 방대한 양의 데이터를 기반으로 운영되며, 시장 참여자들은 필요한 순간 데이터가 정확하고 실시간으로 제공되기를 기대한다”며 “과거에는 레거시 시스템이 데이터를 배치 방식으로 이동시켰기 때문에 팀은 장 마감 후에야 시장 데이터를 분석하고 실행 가능한 리포트를 제공할 수 있었다. 이제는 스노우파이프 스트리밍을 통해 매일 약 2000억 행의 시장 데이터를 스노우플레이크로 불러와 팀은 수 초에서 수 분 내에 쿼리를 처리한다”고 말했다. 이어 “클라우드 확장성과 안정성이 입증된 스노우플레이크 플랫폼에서 팀들이 시장 인사이트와 고객 거래 행태에 실시간으로 접근할 수 있다는 것은 비즈니스 운영에 매우 중요하다”고 덧붙였다.
데이터 위치와 관계없이 AI-레디 데이터 확보 경로 간소화
대규모 데이터 처리를 위한 범용 엔진 ‘아파치 스파크™(Apache Spark™)’를 기반으로 운영하는 조직을 위해 ‘스노우파크 커넥트(Snowpark Connect)’는 스노우플레이크 또는 외부 카탈로그의 대규모 분석 테이블을 위한 고성능 포맷 ‘아파치 아이스버그(Apache Iceberg)’ 테이블과 연동된다. 이번에 ‘데이터프레임 라이터 V2 API 및 유연한 파티셔닝(DataFrame Writer V2 APIs and flexible partitioning)’이 퍼블릭 프리뷰로 공개되면서, 아이스버그 테이블에 데이터를 기록하는 기존 스파크 파이프라인 코드 변경을 최소화해 스노우플레이크로 이전할 수 있게 됐다. 스파크 사용자는 ‘아파치 스파크용 파일 리더(File reader for Apache Spark, 퍼블릭 프리뷰 예정)’로 파일을 스노우플레이크에 직접 불러올 수도 있어 외부 클러스터를 관리하지 않고도 JSON, CSV, 파케이(Parquet) 파일을 빠르게 처리할 수 있다. 퍼블릭 프리뷰로 공개된 ‘아이스버그 테이블 기반 WAP(Write-Audit-Publish on Iceberg tables)’를 활용하면 스파크 사용자는 데이터 브랜치에서 에이전틱 워크로드를 안전하게 생성하거나 새로운 파이프라인을 테스트하고 프로덕션에 반영하기 전에 다운스트림에 미치는 영향을 검증할 수 있다.
코코는 기존 스파크 코드를 검토해 스노우플레이크에서 실행되도록 재작성할 수 있어, 마이그레이션 시 필요한 수작업을 크게 줄어든다. 작업 실행 이후에는 ‘모니터링 UI(Monitoring UI, 퍼블릭 프리뷰)’를 통해 각 작업의 성능을 확인하고 문제의 원인을 신속하게 파악할 수 있다.
스노우플레이크의 이번 혁신은 기업이 AI를 대규모로 확장하는 과정에서 가장 큰 장애 요인 중 하나를 해소한다. 데이터 팀은 비즈니스가 필요로 하는 이니셔티브에 집중할 수 있고, 기업은 모든 에이전트가 신뢰할 수 있는 데이터를 기반으로 작동한다는 확신 아래 더 많은 에이전트를 파일럿에서 생산 단계로 전환할 수 있다.
한편 11월 4일부터 6일까지 3일간 온라인으로 진행되는 ‘스노우플레이크 엑스페디션(Snowflake Expedition)’에서는 스노우플레이크의 최신 제품 기능과 업데이트 내용을 확인할 수 있으며, 스노우플레이크 홈페이지에서 등록을 통해 실시간으로 시청하거나 및 행사 종료 후 다시 볼 수 있다.
더 알아보기:
· 스노우플레이크가 AI 레디 데이터로 기업의 효율적인 인텔리전스 확장을 지원하는 방식은 블로그에서 확인할 수 있다.
· 스노우플레이크가 단일 플랫폼에서 실시간 데이터의 스트리밍, 처리, 분석을 지원하는 방식은 블로그에서 확인할 수 있다.
· 장애 모니터링, 문제 진단, 해결 방안 제안을 자율적으로 수행하는 스노우플레이크의 AI 에이전트에 대한 자세한 내용은 블로그에서 확인할 수 있다.
· 스노우플레이크의 최신 뉴스와 발표 내용은 LinkedIn과 X에서 확인할 수 있으며, #SnowflakeExpedition 해시태그를 통해 관련 소식을 확인할 수 있다.